Actualizado en septiembre de 2026. Esta publicación explica qué es llms.txt, qué puede y qué no puede hacer hoy por un sitio web, y cómo escribir uno que se mantenga exacto.
llms.txt es un archivo de Markdown en texto plano que se sirve en /llms.txt de tu dominio. Les da a los modelos de lenguaje y a las herramientas de IA un mapa corto y curado de tu sitio: quién eres, qué ofreces y qué páginas importan, con enlaces. No controla el rastreo, no es una señal de posicionamiento y ningún proveedor importante de IA se ha comprometido públicamente a leerlo cuando responde preguntas. Es barato de agregar y útil para los agentes y las herramientas de desarrollo que sí lo consultan, y por eso nosotros tenemos uno.
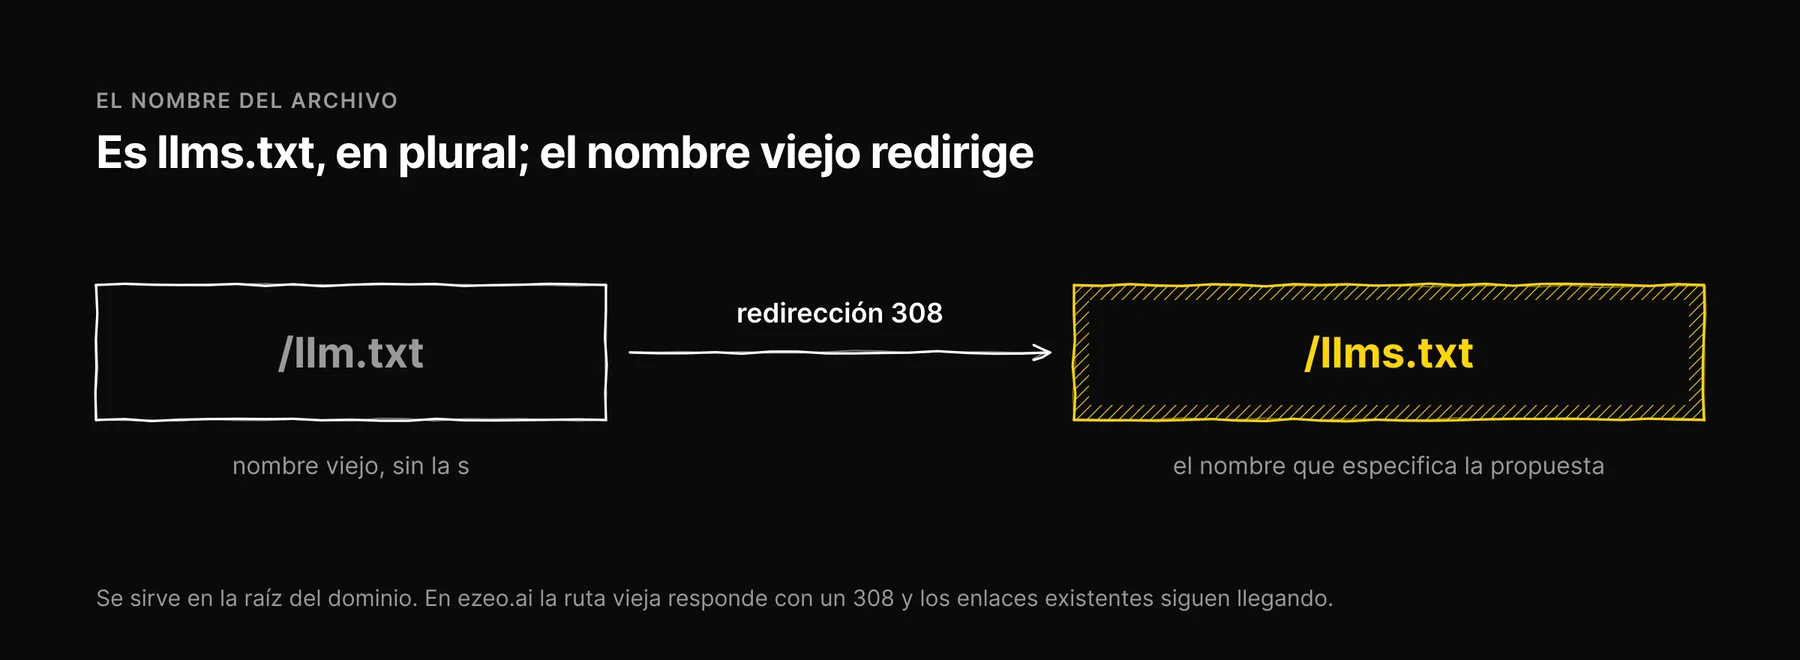
El nombre del archivo es llms.txt, en plural
La propuesta especifica llms.txt, con s, y su ubicación predeterminada es la raíz del dominio.
Si publicaste /llm.txt, renómbralo y agrega una redirección permanente de la ruta vieja a la nueva. Eso es lo que hacemos en ezeo.ai: /llm.txt responde con una redirección 308 a /llms.txt, así que cualquier enlace al nombre anterior sigue llegando al archivo correcto.
De dónde viene llms.txt
Jeremy Howard, de Answer.AI, propuso llms.txt en septiembre de 2024. La especificación está en llmstxt.org. El problema que resuelve es práctico. Un modelo que trabaja con una ventana de contexto limitada se las arregla mal con un sitio web tal como se sirve en realidad: la navegación, los scripts, los avisos de cookies y el marcado de diseño desplazan al contenido. El dueño de un sitio sabe qué páginas explican el negocio. llms.txt le permite decirlo, una sola vez, en un formato que un modelo puede leer sin limpiar nada.
Es una propuesta, no un estándar con un organismo que lo regule, y todavía es joven. Toma lo que sigue como la convención tal como está escrita hoy.
El formato
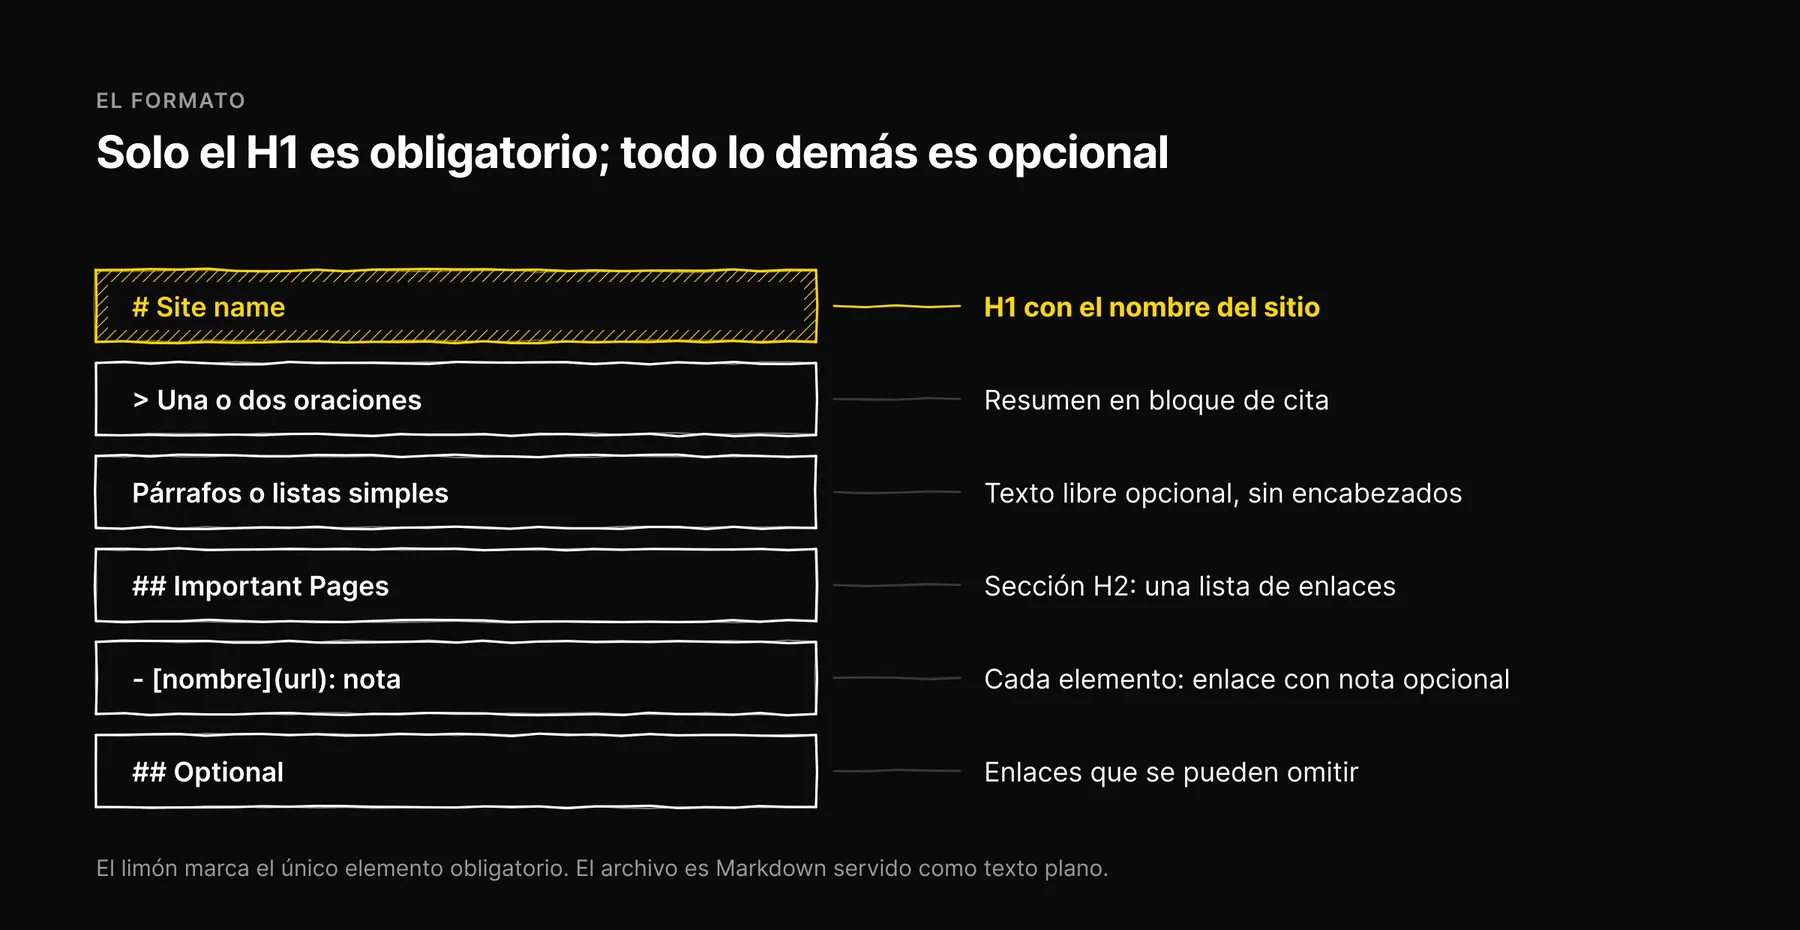
El archivo es Markdown con un orden fijo de partes. Solo la primera es obligatoria.
- Un H1 con el nombre del sitio o del proyecto. Es el único elemento obligatorio.
- Un resumen en bloque de cita. Una o dos oraciones, que empiezan con
>, que dicen qué es el sitio. Escríbelo de modo que quien no vea nada más igual te entienda. - Texto libre opcional. Párrafos o listas con detalles que ayudan a interpretar el resto del archivo. Sin encabezados en esta parte.
- Secciones H2 de enlaces. Cada sección es una lista de Markdown, y cada elemento es un enlace con una nota opcional:
[nombre](url): nota. - Una sección opcional llamada
Optional. Los enlaces bajo un H2 llamado exactamente "Optional" son los que una herramienta puede omitir cuando le falta contexto.
Esta es una versión recortada del archivo que servimos en ezeo.ai. El archivo completo es público en ezeo.ai/llms.txt.
# Ezeo SEO

> Ezeo is an AI-powered SEO, GEO, and AEO workspace for agencies and
> in-house teams, built by JAMAK in Miami, FL.

Ezeo helps brands measure and improve visibility across ChatGPT, Claude,
Gemini, Perplexity, and Google AI Overviews.

## About

- [About Ezeo](https://ezeo.ai/about): who builds Ezeo and why

## What Ezeo Does

- GEO visibility monitoring across 5 tracked AI surfaces
- SEO analytics from Google Analytics 4, Search Console, and Clarity
- Backlinks, rankings, competitor monitoring, and website audits

## Important Pages

- [Documentation](https://ezeo.ai/documentation): how to set up and use Ezeo
- [Blog](https://ezeo.ai/blog): articles on SEO and generative engine optimization
- [Sitemap](https://ezeo.ai/sitemap.xml): every public URL

## Contact

- [Contact Ezeo](https://ezeo.ai/contact)

Last updated: 2026-09-22
Dos cosas de ese archivo son costumbres nuestras y no parte de la especificación. La sección "What Ezeo Does" es una lista simple sin enlaces, algo que el formato permite en el área de texto libre, pero que nosotros ponemos bajo un encabezado porque se lee mejor. Y la línea "Last updated" al final no forma parte de la propuesta. La agregamos porque un archivo con fecha es más fácil de auditar: cualquiera que lo lea, persona o herramienta, puede ver qué tan desactualizado podría estar.
Convenciones complementarias: llms-full.txt y páginas .md
La propuesta describe dos ideas relacionadas que suelen acompañar al archivo principal.
/llms-full.txtcontiene el texto completo de las páginas importantes en un solo archivo, para que una herramienta cargue todo en una sola solicitud en lugar de seguir cada enlace. Va bien para sitios de documentación y sitios pequeños. En un sitio grande crece rápido, y se desactualiza cada vez que cambia cualquier página incluida.- Versiones en Markdown de las páginas. La propuesta sugiere servir una copia limpia en Markdown de una página en la misma URL con
.mdal final. Eso le da a una herramienta el contenido sin el marco de la página. Es más común en la documentación para desarrolladores, donde el público ya usa herramientas de programación con IA.
Ninguna es obligatoria. Empieza con /llms.txt. Agrega las otras si tu público incluye desarrolladores o agentes que las vayan a usar.
Quién lo lee realmente hoy
Esta es la parte que la mayoría de los artículos entiende mal.
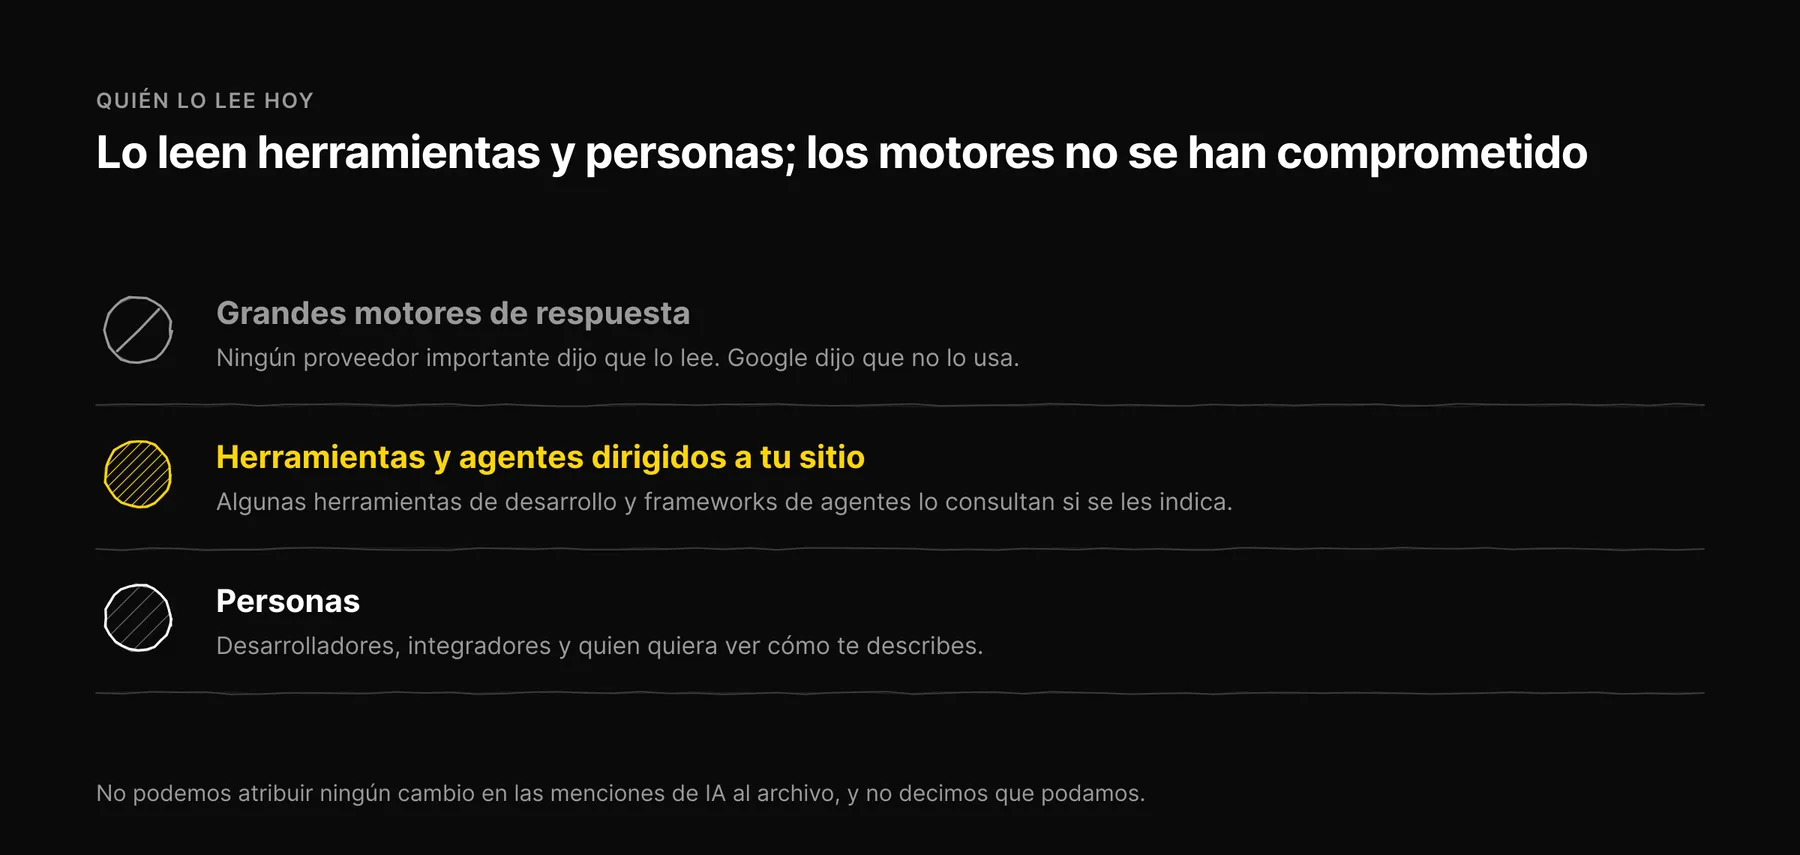
- Los grandes motores de respuesta no se han comprometido. Ningún proveedor importante de IA ha dicho públicamente que lea llms.txt al generar respuestas. Google ha dicho públicamente que no lo usa.
- Las herramientas y los agentes pueden usarlo cuando se les indica. Algunas herramientas de desarrollo, asistentes de programación y frameworks de agentes consultan llms.txt cuando un usuario o desarrollador los dirige a un sitio. En ese contexto el archivo hace un trabajo real: le dice a la herramienta dónde están las páginas útiles.
- Las personas lo leen. Desarrolladores, integradores y cualquiera con curiosidad por cómo te describes. Uno limpio es una pequeña señal de que cuidas las superficies legibles por máquinas.
En Ezeo medimos la visibilidad de una marca haciéndoles a ChatGPT, Claude, Gemini, Perplexity y Google AI Overviews el mismo conjunto de prompts cada semana, y registrando a quién mencionan y qué URLs citan. Nada en esas respuestas nos dice si un motor leyó el llms.txt de un sitio, así que no podemos atribuir ningún cambio en las menciones al archivo, y no decimos que podamos. Si un proveedor te dice que llms.txt subió tu visibilidad en IA, pregúntale cómo lo aisló.
Cómo se relaciona llms.txt con robots.txt, los sitemaps y el schema
Estos archivos responden preguntas distintas. Ninguno reemplaza a otro.
| Archivo | Pregunta que responde | Quién actúa con él |
|---|---|---|
robots.txt | ¿Qué rutas puede consultar cada rastreador? | Los rastreadores que lo respetan, incluidos los de búsqueda y los de IA |
sitemap.xml | ¿Qué URLs existen y cuándo cambiaron? | Los rastreadores de los buscadores |
| Marcado schema (JSON-LD) | ¿Qué datos describen esta página y la entidad detrás de ella? | Los buscadores y los analizadores que leen el marcado de la página |
llms.txt | ¿Qué páginas explican mejor este sitio, en una forma que un modelo pueda leer? | Las herramientas y los agentes que decidan consultarlo |
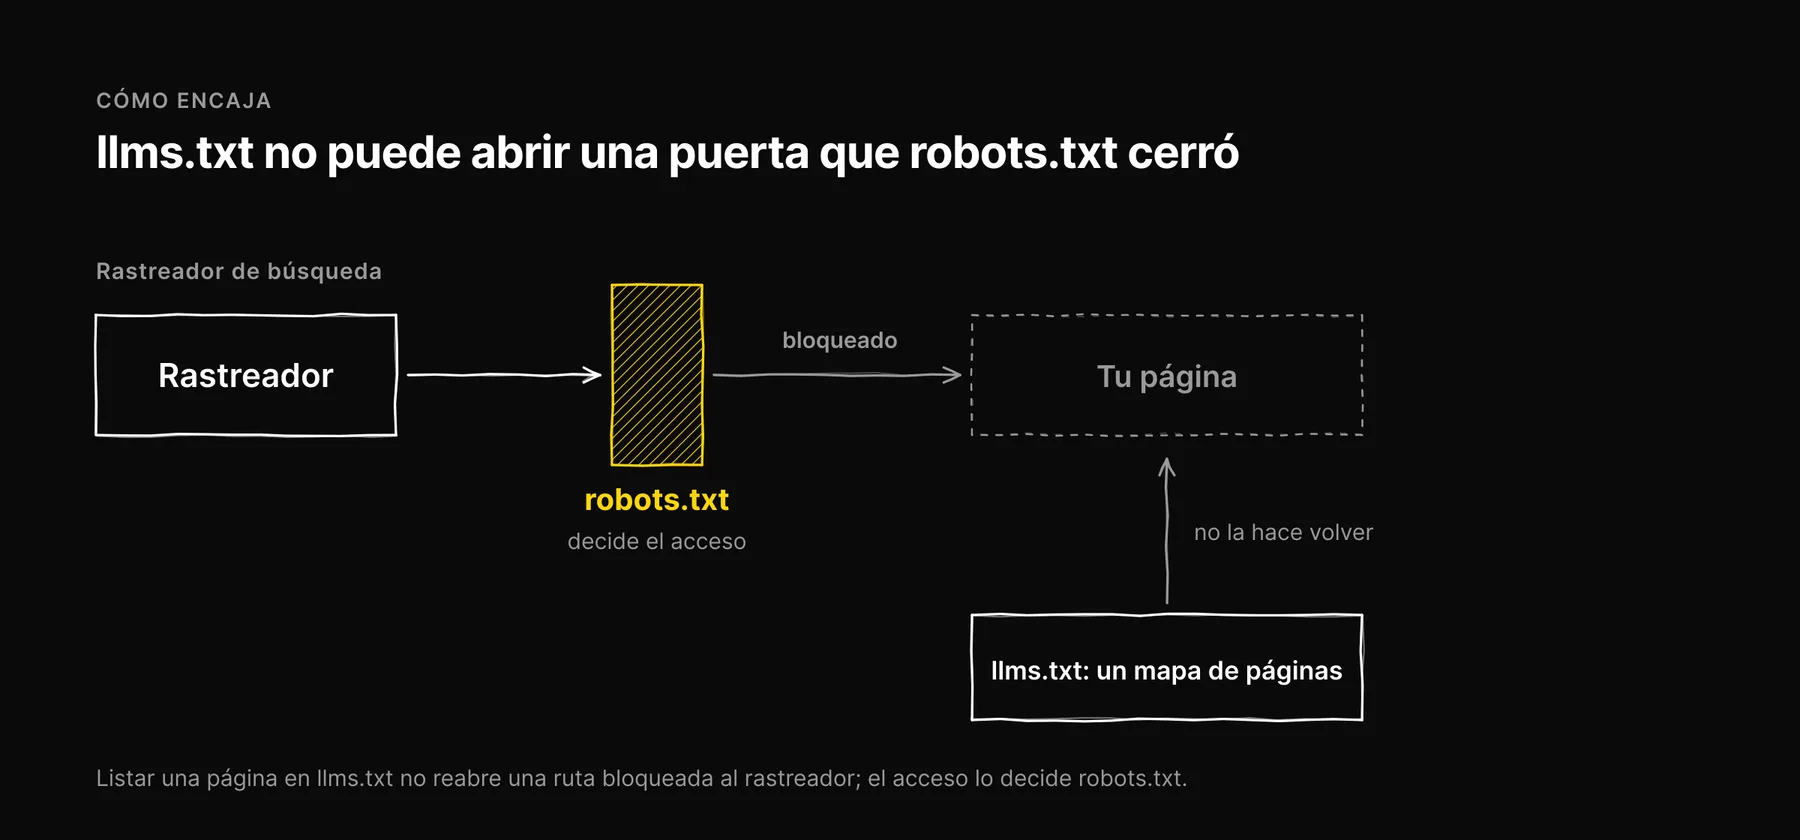
La consecuencia práctica: llms.txt no puede abrir ni cerrar una puerta. Si tu robots.txt bloquea el rastreador que un motor usa para su índice de búsqueda, listar una página en llms.txt no la hace volver. El acceso lo decide robots.txt, siguiendo las reglas del RFC 9309.
Hay un detalle de robots.txt que atrapa a muchos sitios, así que vale un párrafo aquí. Un rastreador obedece solo el grupo User-agent más específico que le corresponde, e ignora el grupo * cuando tiene uno propio. Si agregas un grupo con nombre para un rastreador de IA para darle la bienvenida, y olvidas repetir tus líneas Disallow dentro de ese grupo, acabas de abrir tus rutas privadas justo a ese bot. Nuestro propio robots.txt repite los disallow de /app/ y /api/ en cada grupo con nombre por esta razón. Los nombres de los rastreadores y lo que hace cada uno están documentados por OpenAI, Anthropic y Perplexity; nuestra guía sobre los cinco motores de IA que monitoreamos cubre cómo encuentra páginas cada uno.
Cómo escribir el tuyo
- Crea el archivo en la raíz. Guárdalo como
llms.txty sírvelo enhttps://tudominio.com/llms.txtcomo texto plano. Abre la URL en un navegador y confirma que ves el Markdown sin procesar, no una página HTML ni un 404. - Escribe el H1 y el resumen. Usa el nombre que la gente busca. Mantén el bloque de cita factual: qué eres, para quién es, dónde estás si eso importa. Deja fuera los eslóganes.
- Agrega unas cuantas secciones de enlaces. Elige las páginas que explican el negocio: acerca de, productos o servicios, precios, documentación, contacto. Dale a cada enlace una nota corta que diga qué contiene la página. De diez a treinta enlaces es suficiente para la mayoría de los negocios; es nuestro criterio editorial, no una regla de la especificación.
- Enlaza solo URLs activas y canónicas. Cada enlace debe devolver un 200 y debe ser la versión de la página que quieres que citen, no una variante con rastreo o parámetros.
- Usa "Optional" para el material secundario. Las páginas legales, los archivos y las publicaciones viejas pueden ir ahí.
- Ponle fecha. Termina el archivo con una línea "Last updated: AAAA-MM-DD" y cámbiala cada vez que cambie el contenido.
- Redirige el nombre equivocado. Si alguna vez existió
/llm.txten tu sitio, agrega una redirección permanente a/llms.txt. - Revísalo después de cada despliegue. Los enlaces se rompen. Basta un script rápido que consulte cada URL del archivo y marque todo lo que no sea un 200.
Si tu sitio tiene varios idiomas, mantén un solo archivo en la raíz y agrega una sección por idioma, o enlaza las páginas principales de cada idioma. La especificación no define archivos por idioma, así que es poco probable que las herramientas los busquen.
Cómo mantenemos el nuestro exacto
Tratamos llms.txt como documentación, así que recibe la misma regla que el resto de lo que publicamos: cada afirmación tiene que ser verdadera hoy. Cuando cambia la descripción de un producto, el archivo cambia en el mismo lanzamiento. Cuando una página se mueve, el enlace se mueve. Cuando una afirmación del archivo ya no se puede comprobar contra una página activa, se quita.
El fallo que vigilamos es la deriva. Un llms.txt escrito una vez y olvidado, en cuestión de meses describirá productos que ya retiraste y enlazará páginas que redirigen. Una herramienta que confía en el archivo repite entonces datos obsoletos sobre ti. La línea "Last updated" hace visible esa deriva, y una revisión de enlaces después de cada despliegue atrapa el resto.
Errores comunes
- El nombre de archivo equivocado.
llm.txt,LLMS.txto un archivo solo en una subcarpeta. La propuesta especifica el nombrellms.txt, y su ubicación predeterminada es/llms.txten la raíz. - Texto de marketing. "La plataforma líder del mundo" no le da al modelo nada que pueda usar. Di qué haces, para quién, y enlaza la evidencia.
- Volcar el sitemap. Cientos de enlaces anulan el propósito. El archivo es una lista corta y curada.
- Tratarlo como un arreglo de posicionamiento. Si una página no se cita, las causas suelen ser la página misma, su rastreabilidad o su reputación. Nuestra publicación sobre qué hace que los motores de IA citen un contenido cubre el lado de la página.
- Nunca actualizarlo. Un archivo obsoleto es peor que ninguno, porque entrega datos seguros y equivocados a las herramientas que lo leen.
Dónde encaja en el panorama completo
llms.txt es un elemento pequeño de una lista más larga. El trabajo que mueve la visibilidad en IA es en su mayoría el mismo que mueve la búsqueda: páginas que responden preguntas con datos específicos y con fuente, rastreadores con acceso permitido y una reputación que otros sitios confirman. Nuestra lista completa de visibilidad en IA pone a llms.txt en ese contexto, y nuestra guía para auditar la visibilidad en IA te muestra cómo revisar qué dicen los motores sobre ti antes y después de cambiar cualquier cosa.
Agrega el archivo. Mantenlo corto, factual y con fecha. Luego dedica el resto de tu tiempo a las páginas a las que apunta.
Qué cambió en la actualización de septiembre de 2026: El nombre de archivo es llms.txt, no llm.txt, y el formato ahora sigue la propuesta de llmstxt.org. Quitamos la afirmación de que GPTBot, ClaudeBot y PerplexityBot están empezando a reconocer el archivo, que no tenía fuente.
Frequently asked questions
Written by
Jose Antonio Mijares
Experto en SEO y GEO | Fundador de Ezeo