Actualizado en septiembre de 2026. Este es un método paso a paso para auditar cómo ChatGPT, Claude, Gemini, Perplexity y Google AI Overviews describen y recomiendan tu marca, con una hoja de cálculo que puedes llevar a mano.
Escribe un conjunto fijo de prompts sobre tu marca y tu categoría, ejecuta cada uno en los cinco motores al menos tres veces bajo condiciones registradas, y anota si te mencionaron, cómo te describieron y qué URLs citaron. Mantén "sin verificar" separado de "no mencionado". El resultado es una línea base que puedes repetir, y eso vale más que cualquier captura de pantalla suelta.
Auditoría de visibilidad en IA: una revisión repetible de si los motores de respuesta con IA mencionan tu marca ante las preguntas que hacen tus compradores, con qué precisión la describen y qué fuentes citan cuando lo hacen.
Paso 1: Fija tus condiciones antes de ejecutar nada
Las respuestas de la IA varían. El mismo prompt en el mismo motor puede nombrar marcas distintas en días distintos, y los resultados cambian entre usar la sesión iniciada o cerrada y según la ubicación. Si no mantienes las condiciones estables, tu auditoría mide ruido.
Decide y anota, una sola vez:
- Estado de la cuenta. Sin iniciar sesión donde el motor lo permita, o una cuenta limpia con la memoria y la personalización desactivadas. No audites desde la cuenta que usas a diario: ya sabe quién eres.
- Ubicación. Desde dónde ejecutas la auditoría y si usas una VPN. Los resultados de Google, en particular, cambian según la ubicación.
- Modo. Qué modelo o modo usaste y si la búsqueda web estaba activada. Anótalo en cada ejecución si el motor lo decide por su cuenta.
- Ejecuciones por prompt. Nosotros usamos tres. Es suficiente para ver si una respuesta es estable y lo bastante pequeño para hacerlo a mano.
Paso 2: Prepara la hoja de cálculo
Una fila por ejecución, no por prompt. Estas son las columnas que usamos.
| Columna | Qué se anota | Ejemplo |
|---|---|---|
| Fecha | Cuándo se hizo la ejecución | 2026-09-22 |
| Motor | Uno de los cinco | Perplexity |
| Condiciones | Estado de la cuenta, ubicación, modo | Sin sesión, Miami, predeterminado |
| ID y texto del prompt | El prompt exacto, nunca parafraseado | C3: "Mejores herramientas de SEO para pequeñas empresas" |
| Ejecución | 1, 2 o 3 | 2 |
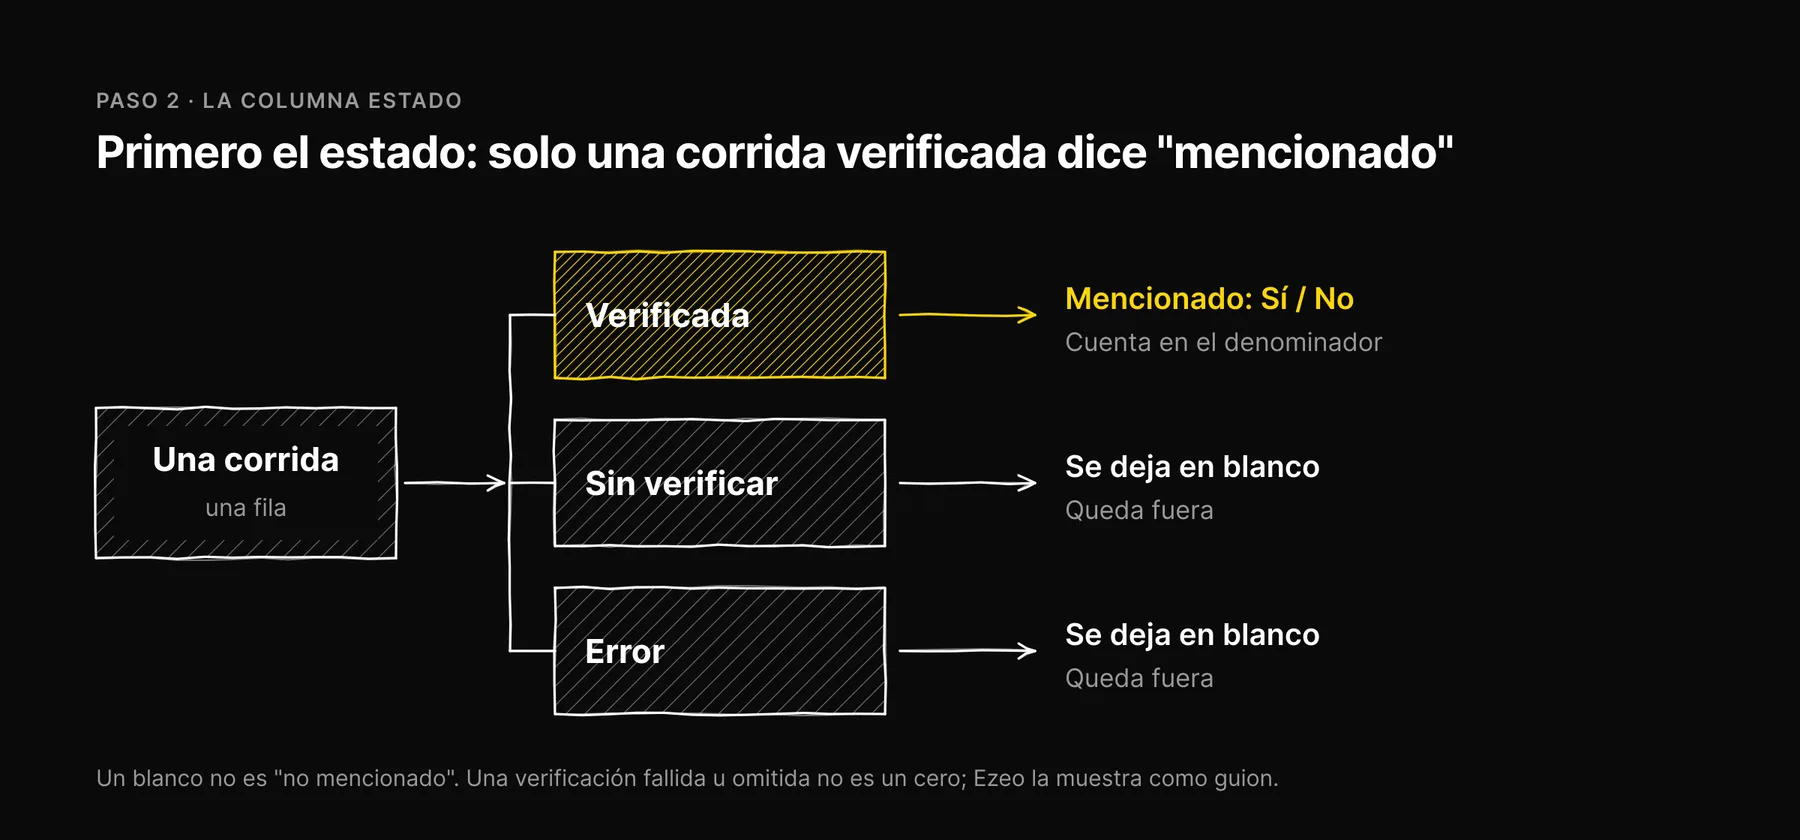
| Estado | Verificada / Sin verificar / Error | Verificada |
| Mencionado | Sí / No (solo si está Verificada) | No |
| Precisión | Correcta / Parcial / Errónea, anotando la afirmación errónea | n/a |
| Competidores nombrados | Todas las marcas que aparecen en la respuesta | Tres competidores, con su nombre |
| URLs citadas | Todos los enlaces de fuentes que se muestran, tuyos y de otros | Dos sitios de reseñas, un hilo de foro |
| Notas | Cualquier cosa fuera de lo normal | "La respuesta solo listó herramientas para empresas grandes" |
Por qué importa la columna Estado
Un error común en las auditorías es leer una celda en blanco como "no mencionado". Si esa semana te saltaste Claude, o Google no mostró AI Overview, o el motor dio error, esa ejecución no se midió. No es un cero. En Ezeo mostramos un guion para todo lo que no verificamos, nunca un 0, porque una verificación fallida no es un cero. Registra primero el estado y llena "Mencionado" solo cuando el estado sea Verificada.
Paso 3: Escribe el conjunto de prompts
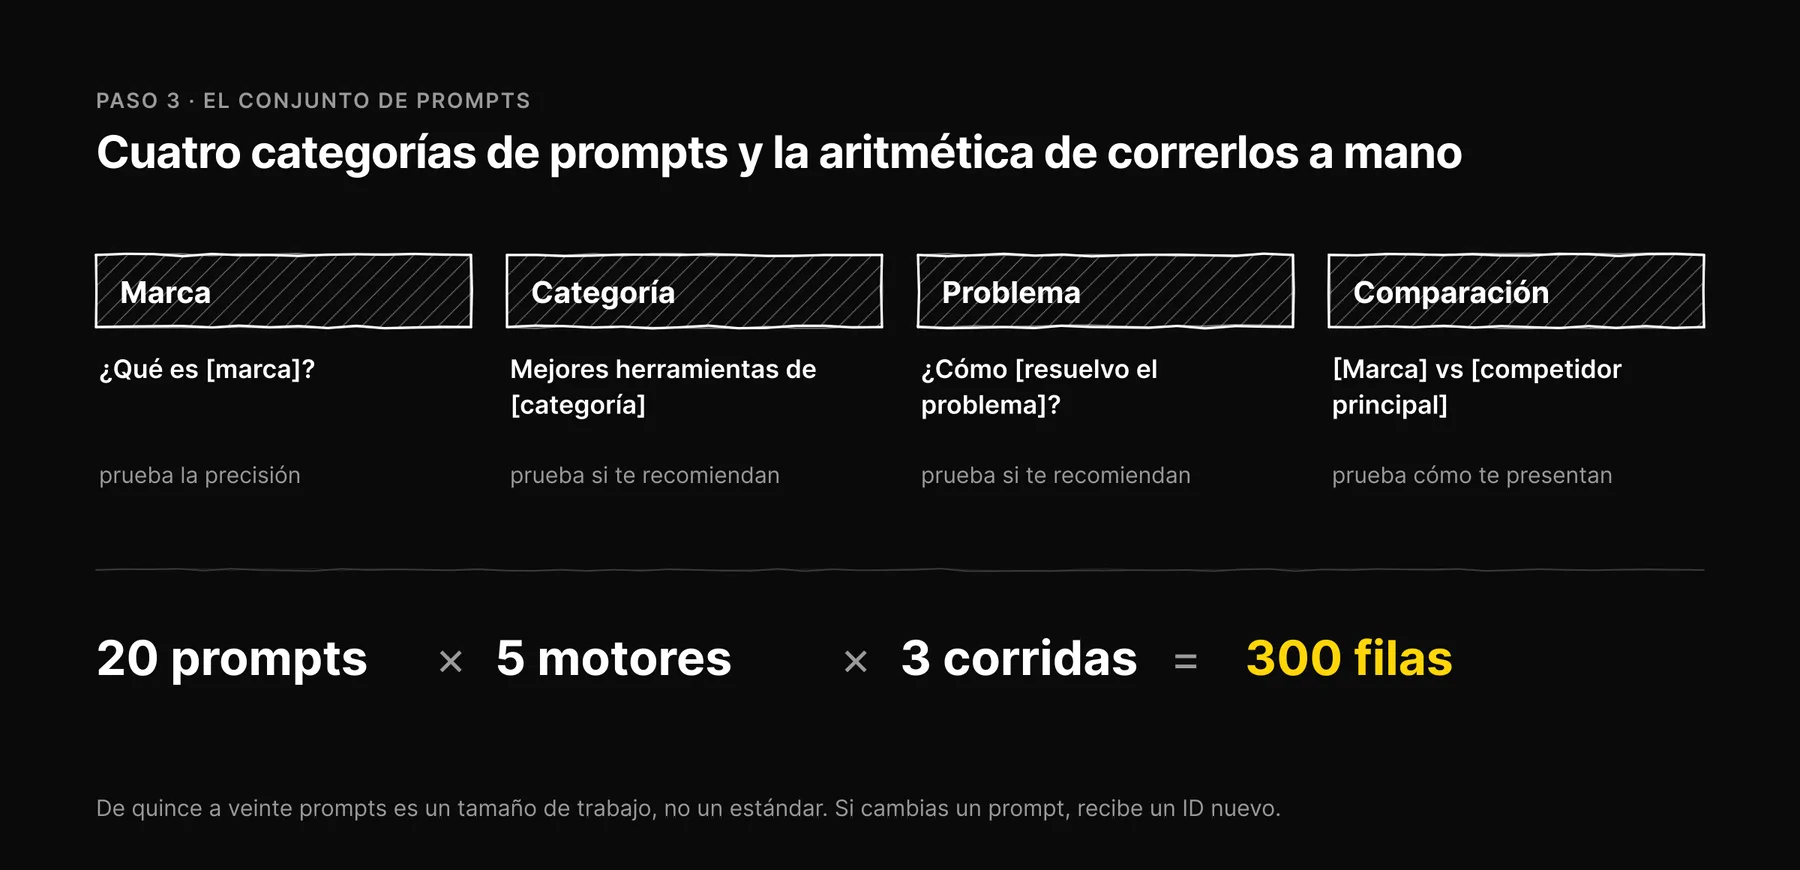
Usa cuatro categorías y escribe los prompts como los escribiría un comprador. Entre quince y veinte prompts es nuestro tamaño de trabajo, no un estándar de la industria: suficiente para cubrir las cuatro categorías, y poco para ejecutarlo a mano. Ten presente la aritmética. Veinte prompts, cinco motores y tres ejecuciones son 300 filas.
Prompts de marca
- "¿Qué es [tu marca]?"
- "Reseña de [tu marca]"
- "¿[Tu marca] es buena para [tu público]?"
Prompts de categoría
- "Mejores herramientas de [categoría] para [público]"
- "Principales plataformas de [categoría] en 2026"
- "Software de [categoría] para [caso de uso]"
Prompts de problema
- "¿Cómo [resuelvo el problema que tú resuelves]?"
- "¿Qué herramientas ayudan con [el problema que tú resuelves]?"
Prompts de comparación
- "[Tu marca] vs [competidor principal]"
- "Alternativas a [competidor]"
Los prompts de marca prueban la precisión. Los de categoría y de problema prueban si te recomiendan en absoluto, y son los que más importan para conseguir clientes nuevos. Mantén el conjunto fijo entre auditorías. Si cambias un prompt, dale un ID nuevo para no comparar preguntas distintas.
Paso 4: Ejecútalo en los cinco motores
Abre un chat nuevo para cada ejecución, para que las respuestas anteriores de la conversación no se filtren en las siguientes.
Google AI Overviews y AI Mode
Busca desde una ventana privada. Los AI Overviews no aparecen en todas las consultas, así que registra tres resultados distintos: no se mostró AI Overview, se mostró sin tu marca, se mostró con tu marca. "No se mostró AI Overview" es Sin verificar para esa ejecución, no un fallo. Si también revisas AI Mode, anótalo como una fila de motor aparte, porque las respuestas son distintas. Google dice que no hay nada extra que hacer para ser elegible, más allá de estar indexado y ser elegible para fragmentos, según su guía sobre las funciones de IA.
ChatGPT
Usa un chat nuevo cada vez y anota si la respuesta buscó en la web y mostró fuentes. Las respuestas que buscan y las que no pueden ser muy distintas para el mismo prompt. Registra cada URL citada.
Perplexity
Perplexity muestra sus fuentes junto a la respuesta, lo que lo vuelve el motor más fácil de auditar. Registra todas las URLs, no solo las tuyas. La lista de sitios de terceros que cita para tu categoría es uno de los resultados más útiles de toda la auditoría.
Claude
Claude tiene búsqueda web desde 2025, así que no se limita a lo que aprendió en el entrenamiento. Anota si buscó en cada ejecución. Si responde sin buscar, ves lo que el modelo aprendió; si busca, ves lo que encontró.
Gemini
Usa la app de Gemini, el producto que la gente realmente usa, y no Google AI Studio, que es una consola para desarrolladores para llamar a los modelos directamente. Sus respuestas pueden diferir de las de la app para consumidores, así que no te dice lo que ven tus compradores. Gemini puede basar sus respuestas en resultados de Google Search, así que anota si se muestran fuentes.
¿Y Reddit?
Reddit no es uno de los cinco, y Ezeo no lo puntúa. No necesitas auditarlo como motor. Lo que sí debes hacer es buscar hilos de Reddit entre las URLs citadas de arriba. Si aparecen en tus prompts de categoría, Reddit es una fuente que moldea las respuestas en tu mercado, y vale la pena leer los hilos mismos.
Paso 5: Calcula la puntuación
Calcula solo con las ejecuciones Verificadas. Las filas sin verificar y con error se quedan fuera del denominador.
| Medida | Cómo se calcula |
|---|---|
| Tasa de menciones | Ejecuciones que te mencionan, divididas entre las ejecuciones verificadas, por motor y en total |
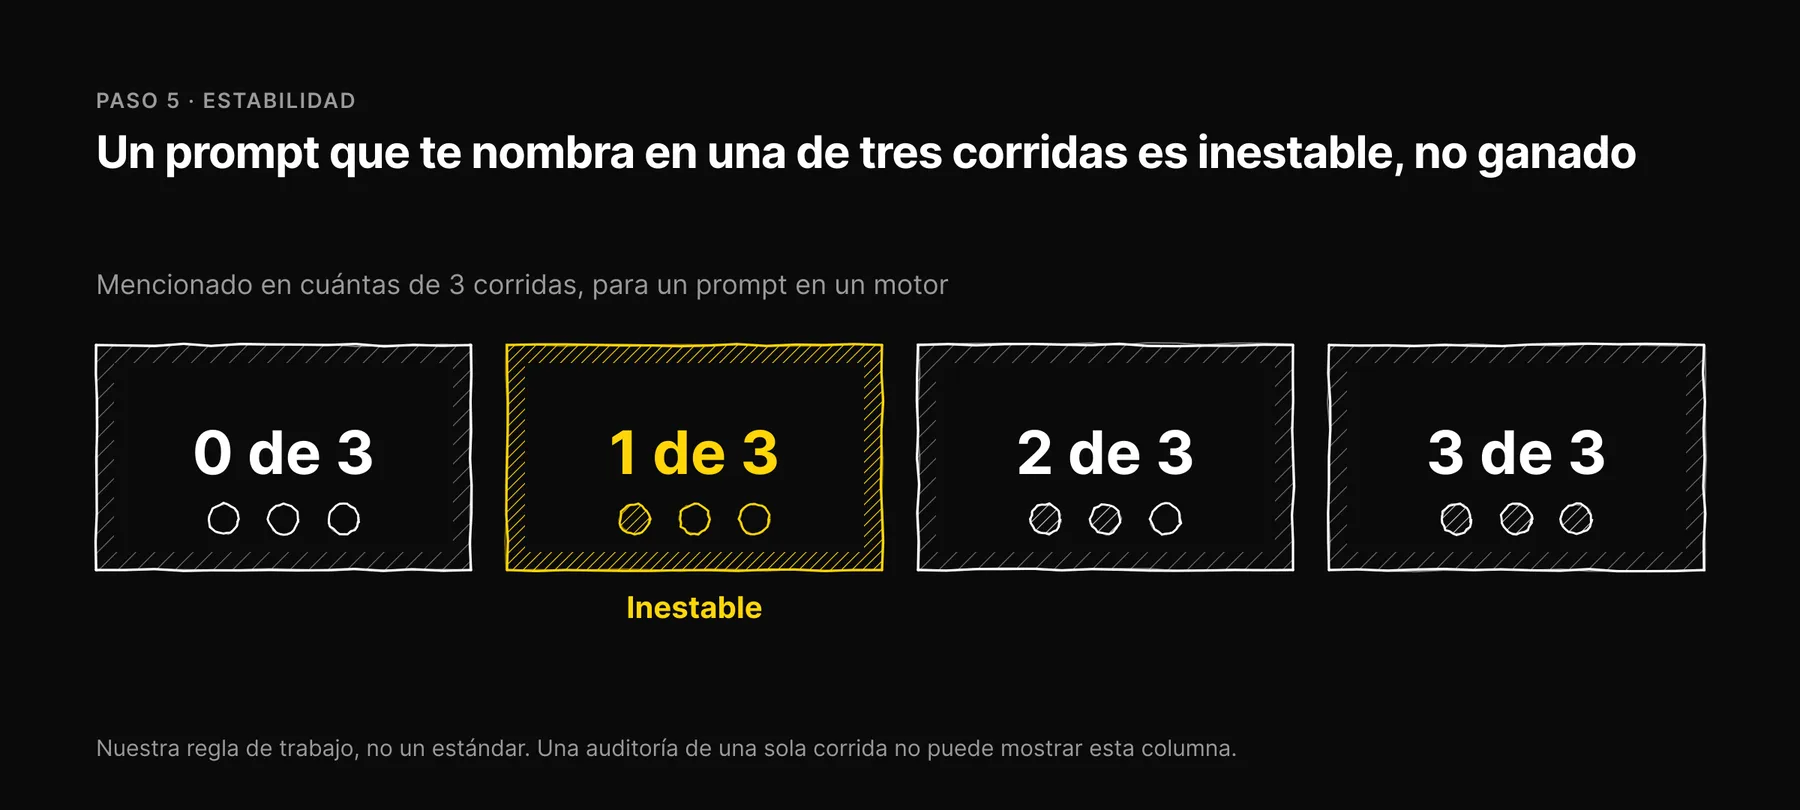
| Estabilidad | Para cada prompt y motor: mencionado en 0, 1, 2 o 3 de 3 ejecuciones |
| Precisión | Proporción de menciones marcadas como Correcta, más una lista de cada afirmación errónea |
| Cuota de competidores | Con qué frecuencia se nombra a cada competidor en las mismas ejecuciones verificadas |
| Fuentes citadas | Cuáles de tus URLs se citan y cuáles URLs de terceros se citan en su lugar |
La estabilidad es la columna que una auditoría de una sola ejecución no puede mostrar. Nuestra regla de trabajo, no un estándar de la industria: un prompt que te nombra en una de tres ejecuciones es inestable, no ganado. Repórtalo así.
No existe un referente de la industria con fuente para una buena tasa de menciones. Depende de la categoría, del número de competidores y del conjunto de prompts. Compárate con dos cosas que sí puedes medir: tu última auditoría y los competidores con nombre, en los mismos prompts.
Paso 6: Convierte los hallazgos en trabajo
- Sin verificar en un motor que te importa. Cierra primero esa brecha. No puedes actuar sobre lo que no mediste.
- Verificado, nunca mencionado. Empieza por el acceso: ¿tu robots.txt permite el rastreador de ese motor? Nuestra guía sobre los cinco motores de búsqueda con IA lista los user-agents. Luego repasa la lista completa de visibilidad en IA.
- Mencionado, pero descrito mal. Revisa las URLs citadas para encontrar el origen de la afirmación errónea. Corrige primero tu propia página y luego pide a los sitios de terceros que corrijan la suya. Un archivo
/llms.txtcon un resumen preciso es barato de agregar, aunque ningún motor importante se ha comprometido a leerlo; consulta qué es llms.txt y qué puede y qué no puede hacer. - Nombran a tus competidores, no a ti. Revisa qué páginas citan los motores para esos prompts. Si son páginas de comparación en las que no apareces, escribe tú una honesta.
- Menciones inestables. Las páginas que enuncian la respuesta con claridad y citan evidencia le dan a los motores menos razones para sustituirte. Consulta las señales de contenido que los modelos de IA realmente citan.
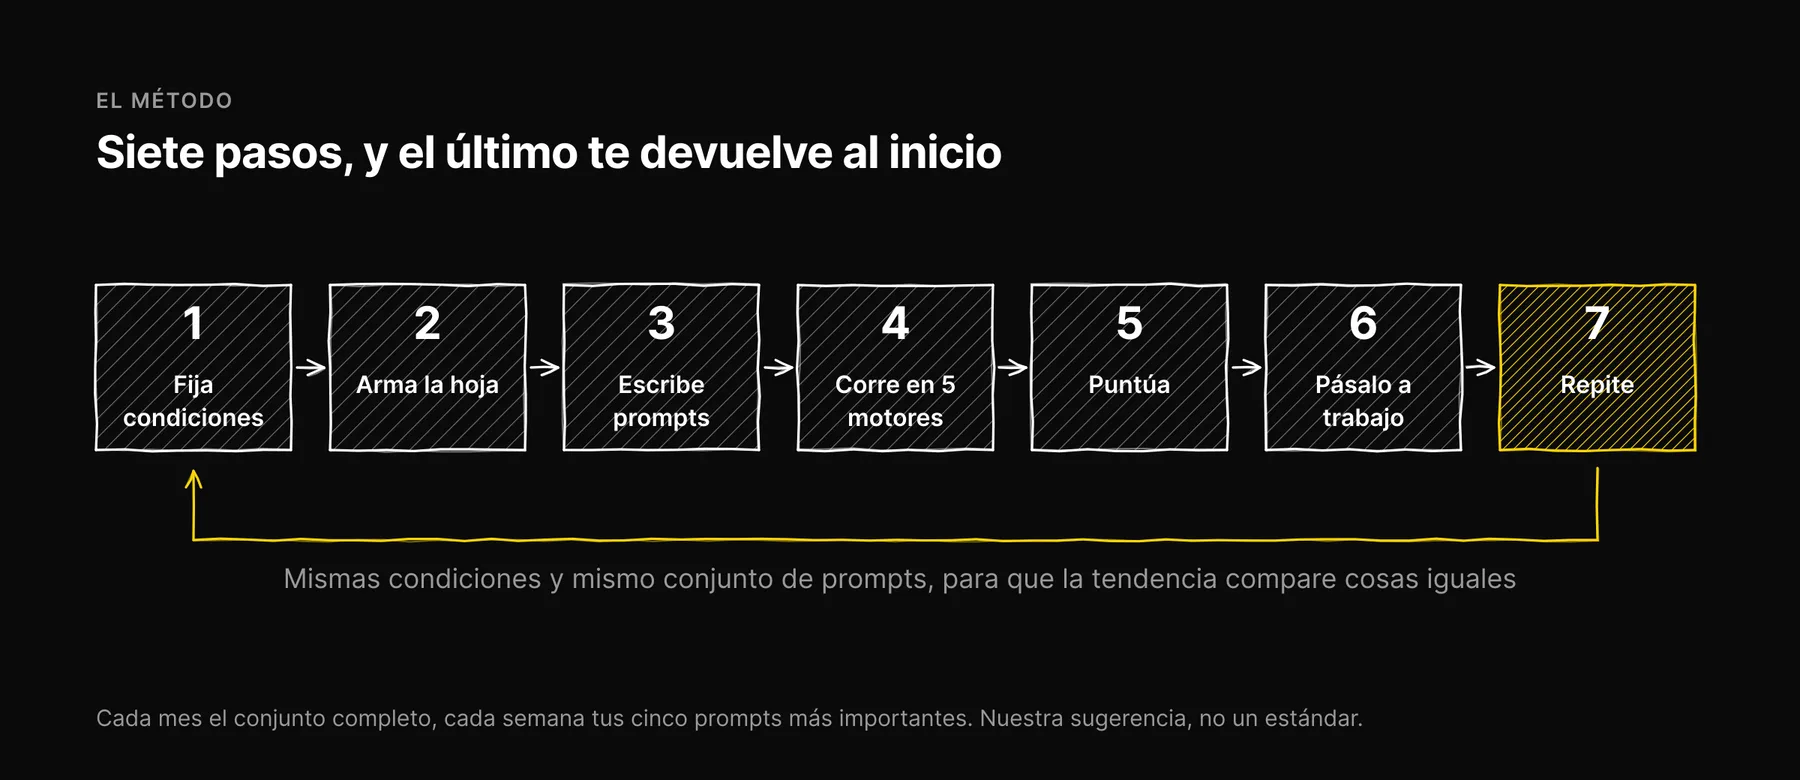
Paso 7: Repite con un calendario
Nuestra sugerencia para una auditoría manual: el conjunto completo de prompts cada mes, y una revisión semanal de tus cinco prompts más importantes en los motores que más usan tus compradores. Cambia el conjunto de prompts solo cada trimestre y mantén las mismas condiciones cada vez, o la línea de tendencia compara cosas distintas.
Este es el método que Ezeo ejecuta de forma automática. Cada semana les hacemos a los cinco motores el mismo conjunto fijo de prompts, registramos las menciones y las URLs citadas, y leemos Google AI Overviews desde la página de resultados en vivo a través de DataForSEO, en lugar de simularlos. La hoja de cálculo de arriba es la misma idea, hecha a mano.
Qué cambió en la actualización de septiembre de 2026: Ezeo audita cinco motores, no seis (Reddit es una fuente, no un motor), Claude tiene búsqueda web desde 2025, Gemini debe revisarse en la app de Gemini y no en Google AI Studio, y el archivo es llms.txt, no llm.txt. Se eliminaron los rangos saludables objetivo sin fuente.
Frequently asked questions
Written by
Jose Antonio Mijares
Experto en SEO y GEO | Fundador de Ezeo